
Toute application finit par tomber. Et quand je dis « tomber » je veux bien évidemment dire, ne plus fonctionner. Le mode dégradé d’une application interne, c’est ce qui se passe ce jour-là. Et ce qui est paradoxale avec cette affirmation, c’est que cela est à peu près la seule chose qu’on puisse affirmer avec certitude d’un outil numérique. Souvent, la vraie question au final n’est pas si cela va s’arrêter, mais « QUAND ».
Lorsqu’on prend le dossier patient, la question est réglée avant la signature du marché. Il y a une procédure papier déjà définie, des fiches réflexes, un test annuel mis en place, une formation des nouveaux arrivants… Même chose pour le laboratoire, pour la pharmacie, pour la gestion administrative du malade. C’est une exigence, pas une bonne pratique optionnelle.
Pour une application construite dans un service en une après-midi, RIEN. Pas de procédure, pas de test, pas de référent.
Ce n’est pas de la négligence. Ces applications ne passent par aucune instance, donc par aucun moment où quelqu’un aurait eu le réflexe de poser la question. Le mode dégradé n’a pas été écarté après examen. Il n’a jamais existé comme sujet.
La panne, elle, existe. Et le jour où elle arrive, le service découvre en même temps qu’il dépendait de l’outil et que personne n’avait prévu de s’en passer.
Ce qui a changé
Avant, un outil bricolé dans un service, c’était un fichier. Quand il cassait, on rouvrait la sauvegarde de la semaine dernière et on perdait une demi-journée. Personne ne parlait de continuité d’activité pour un tableur, et ce n’était pas grave, parce qu’un tableur ne tombe pas vraiment (sauf cas particulier embarquant des macros/VBA).
Aujourd’hui, une après-midi suffit à produire une vraie application. Une interface, une base de données, des comptes utilisateurs, une adresse web, un hébergement quelque part.
La capacité à créer a explosé. La capacité à maintenir n’a pas bougé d’un centimètre. Tout l’écart est là.
Il y a un effet secondaire qu’on sous-estime. Une application inspire confiance. Un fichier partagé, on s’en méfie un peu, on garde un œil, on refait le calcul à la main de temps en temps. Une application avec une interface propre, on arrête de vérifier. On lui confie le processus entier, et on laisse tomber l’ancien. C’est précisément à ce moment-là qu’elle devient critique, et c’est précisément à ce moment-là que personne ne s’en rend compte.
Ce qui tombe vraiment
4 pannes, dans l’ordre où on les rencontre.
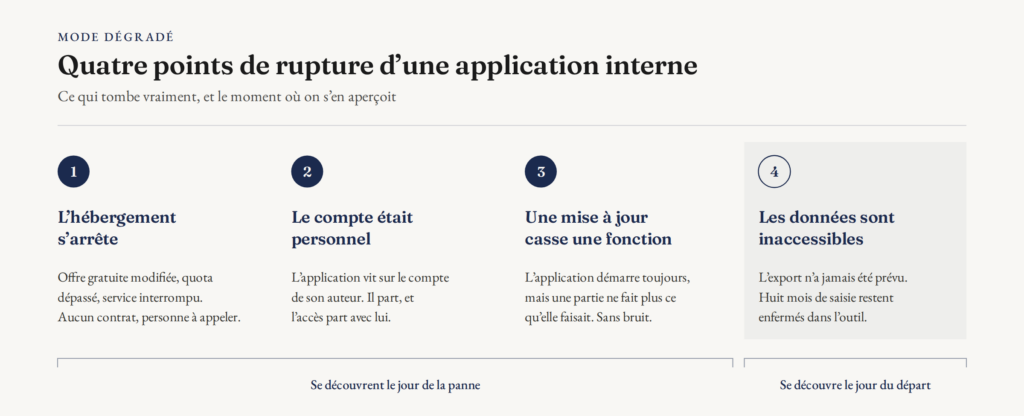
L’hébergement s’arrête. Offre gratuite qui change de conditions, quota dépassé, service interrompu du jour au lendemain. Vous n’avez pas de contrat, donc pas d’engagement de service, donc personne à appeler.
Le compte était personnel. L’application vit sur le compte de son auteur, avec son adresse mail à lui. Il change de service, il part, ou il oublie simplement de renouveler quelque chose. Le service perd l’accès sans qu’aucune technique n’ait lâché. La clé appartenait à une personne, pas à l’établissement.
Une mise à jour casse une fonction. Le modèle évolue, une dépendance change, une interface tierce est modifiée. L’application démarre toujours, mais une partie ne fait plus ce qu’elle faisait. C’est la panne la plus vicieuse, parce qu’elle ne fait aucun bruit. On s’en aperçoit sur les résultats, parfois des semaines plus tard.
Les données sont là et inaccessibles. L’application tourne peut-être encore très bien. Mais l’export n’a jamais été prévu, la base est hébergée on ne sait où, et la seule façon de récupérer huit mois de saisie serait de recopier les écrans un par un.
Les trois premières se voient le jour de la panne. La quatrième ne se découvre que le jour où on veut partir.
Le mode dégradé d’une application interne : trois questions à poser
Aucune ne demande de compétence technique. Une direction des soins peut les poser. Un cadre peut se les poser à lui-même, avant de proposer l’outil au reste de l’équipe.
1.Si l’application s’arrête demain matin, comment le service travaille-t-il ce jour-là ? La réponse doit tenir sur une page, et cette page doit exister ailleurs que dans l’application.
2.Qui sait la relancer, en dehors de la personne qui l’a construite ? Si la réponse est personne, ce n’est pas un outil de service. C’est un outil personnel dont un service a pris l’habitude de dépendre. La nuance change tout.
3.Où sont les données, et comment on les sort ? La bonne manière de répondre n’est pas de l’expliquer, c’est de le faire une fois, devant témoin, et de regarder le fichier obtenu. Un export testé vaut mille engagements verbaux.
Trois questions, dix minutes. C’est à peu près le seul contrôle qui tienne sans instance, sans comité et sans procédure.
Où ça se règle dans le CLAS
Dans la grille de labellisation des applications développées en interne, le mode dégradé n’est pas un contrôle ajouté à la fin. C’est l’un des deux critères transversaux, celui qui sépare l’application qu’on tolère de l’application sur laquelle un service a le droit de s’appuyer.
Un prototype a le droit d’arrêter de fonctionner. C’est même sa définition. Usage local, limites assumées, personne d’autre n’en dépend. À partir du moment où l’application remplace un processus existant, elle documente son mode dégradé. Sinon elle ne monte pas d’un cran, quelle que soit sa qualité par ailleurs.
Et comme un label se perd, le critère continue de s’appliquer après coup. Procédure de retour qui n’est plus à jour, référent parti sans remplaçant, export qui ne fonctionne plus : l’application redescend. Ce n’est pas une sanction, c’est la mise à jour d’un état réel.
Pour finir
Une application ne devient pas critique le jour où on la met en service. Elle le devient le jour où quelqu’un supprime l’ancien tableau parce qu’il faisait doublon.
Ce jour-là, il n’y a pas de réunion, personne ne note rien, et le service vient pourtant de changer de catégorie de risque.
Le cadre complet, la grille de labellisation et le détail des critères de continuité sont dans le livre blanc Vibe Coding Santé.

Laisser un commentaire